数据中心全生命周期运营服务 解锁算力中心高效能之路
随着数字经济加速发展,算力中心作为关键基础设施,其运营水平直接决定了算力资源的利用效率与业务连续性。算力中心运营并非简单的设备维护,而是一项覆盖规划、建设、运维、优化至退役的复杂系统工程。数据中心全生命周期技术服务正是应对这一挑战的核心抓手,通过端到端的能力保障,让算力中心从“高投入”走向“高价值”。
一、全生命周期运营:从“被动响应”到“主动管理”
传统数据中心运营往往偏重故障后处理,导致成本高企、资源利用率低下。全生命周期运营服务强调规划咨询、设计优化、建设监管、运维管理、运营优化、退役处置六个阶段的闭环协同。在规划阶段,结合业务场景进行容量与能效建模;在建设阶段,实施关键节点技术监督;在运维阶段,采用预防性维护与智能监控,确保系统可用性达到99.99%以上。针对算力中心高密集、高功耗特点,更需将制冷、供配电与IT负载联动优化,实现从“温控”到“智控”的跃升。
二、全生命周期技术服务:数据驱动的精细化管理
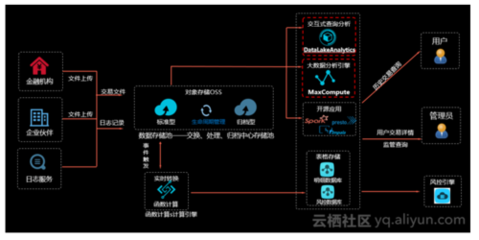
数据中心全生命周期技术服务的核心在于以数据为纽带,打通信息孤岛。在基础设施层,部署物联网传感器实时采集供配电、制冷、环境数据;在IT层,横向融合动环监控、网管系统与算力调度平台;在服务层,通过自研运维管理平台实现故障智能定界、性能趋势预测与资产灵活调配。数据处理和存储服务是技术服务的底座——海量时序数据需要对标清洗、关联分析,并依托分布式存储实现秒级检索与长期归档,为能效优化、故障根因追溯提供支撑。例如,基于历史温湿度与负载数据建立热场模型,可动态调整空调策略,降低PUE;基于磁盘及网络流量劣化分析,提前识别存储瓶颈,避免业务中断。
三、算力中心运营服务:保障算力资源“即取即用”
算力中心的核心产出是算力,其运营服务需兼顾技术运营与商业运营。技术运营聚焦供电、制冷、网络、服务器及集群的稳定性,通过标准化流程(如ITIL)和自动化巡检,构建“软硬一体”的运维体系;商业运营则需匹配业务带宽,实现算力资源计量、调度和计费透明化,并建立SLA分级保障机制。面向AI训练等高负荷场景,全生命周期服务延伸至性能调优、能效试点测试和运营指标诊断,帮助用户在算力密集业务中达成低延迟与资源饱和达标用的最优平衡。从财务面达成总体拥有成本(TCO)的合理管控,避免重复建设、算力误划及潜在安全因素致浪费。
四、全周期统筹下的数据底座与决策赋能
覆盖上述整体交付的主要难点在于跨系统高度服从性管理与应急一致性部署。应当通过统一的运行大后台(AIOps)融合动环监控与日志审计等原始数据归集分流到运维中心集窗,依权限切类提供给各部门协调看板;建立周期性备份及灾备异步切换,守护数据领域核心安全和合规防线。完善质量服务体系中提前评估换代退化区间,精细坐标年度巡查和例行测动的服务生命周期链衔接安排规划;可持续的服务修正清单、模型维护经费测决算评价与每年实操成本预测。在全链条层面构建可持续的反馈和建议机制。逐渐落实形成单元负责人下沉、科学前瞻调度资源、并上线技术变更强制数据图表审定试验模板将关键指标先僵化固定模拟、并行化不断衍生、后续规划迭代逐层级提高一体化预算与标准优化控制要求。通过可控的可定相发展路线,服务于升级需求和趋势预测前瞻布局期必要处技改深化不落后、更无缝联接运营的全业态价值导向合力格局。
如若转载,请注明出处:http://www.ghostplans.com/product/89.html
更新时间:2026-11-21 13:27:04